用 AI 的时候,最让人不安的不是它说错,是它说得那么顺。
一段编出来的东西,读起来和真的几乎没有区别:格式对、术语对、语气也对。要理解这件事,得先看清它给你的那句回答是怎么来的。
它给你一段话,里面有一个具体年份和一个机构名称,读起来通顺,来源也提了。
按上面拆解的逻辑,第一步该核哪个?
点一下你的选择,看答案
B。年份和机构名属于「要精确」的那一类,唯一可靠的办法是回到原文。这也是它最容易出错的地方。
自测:你上一次把 AI 给的内容直接用了,是哪个部分没核?
五个环节,没有一环在核对
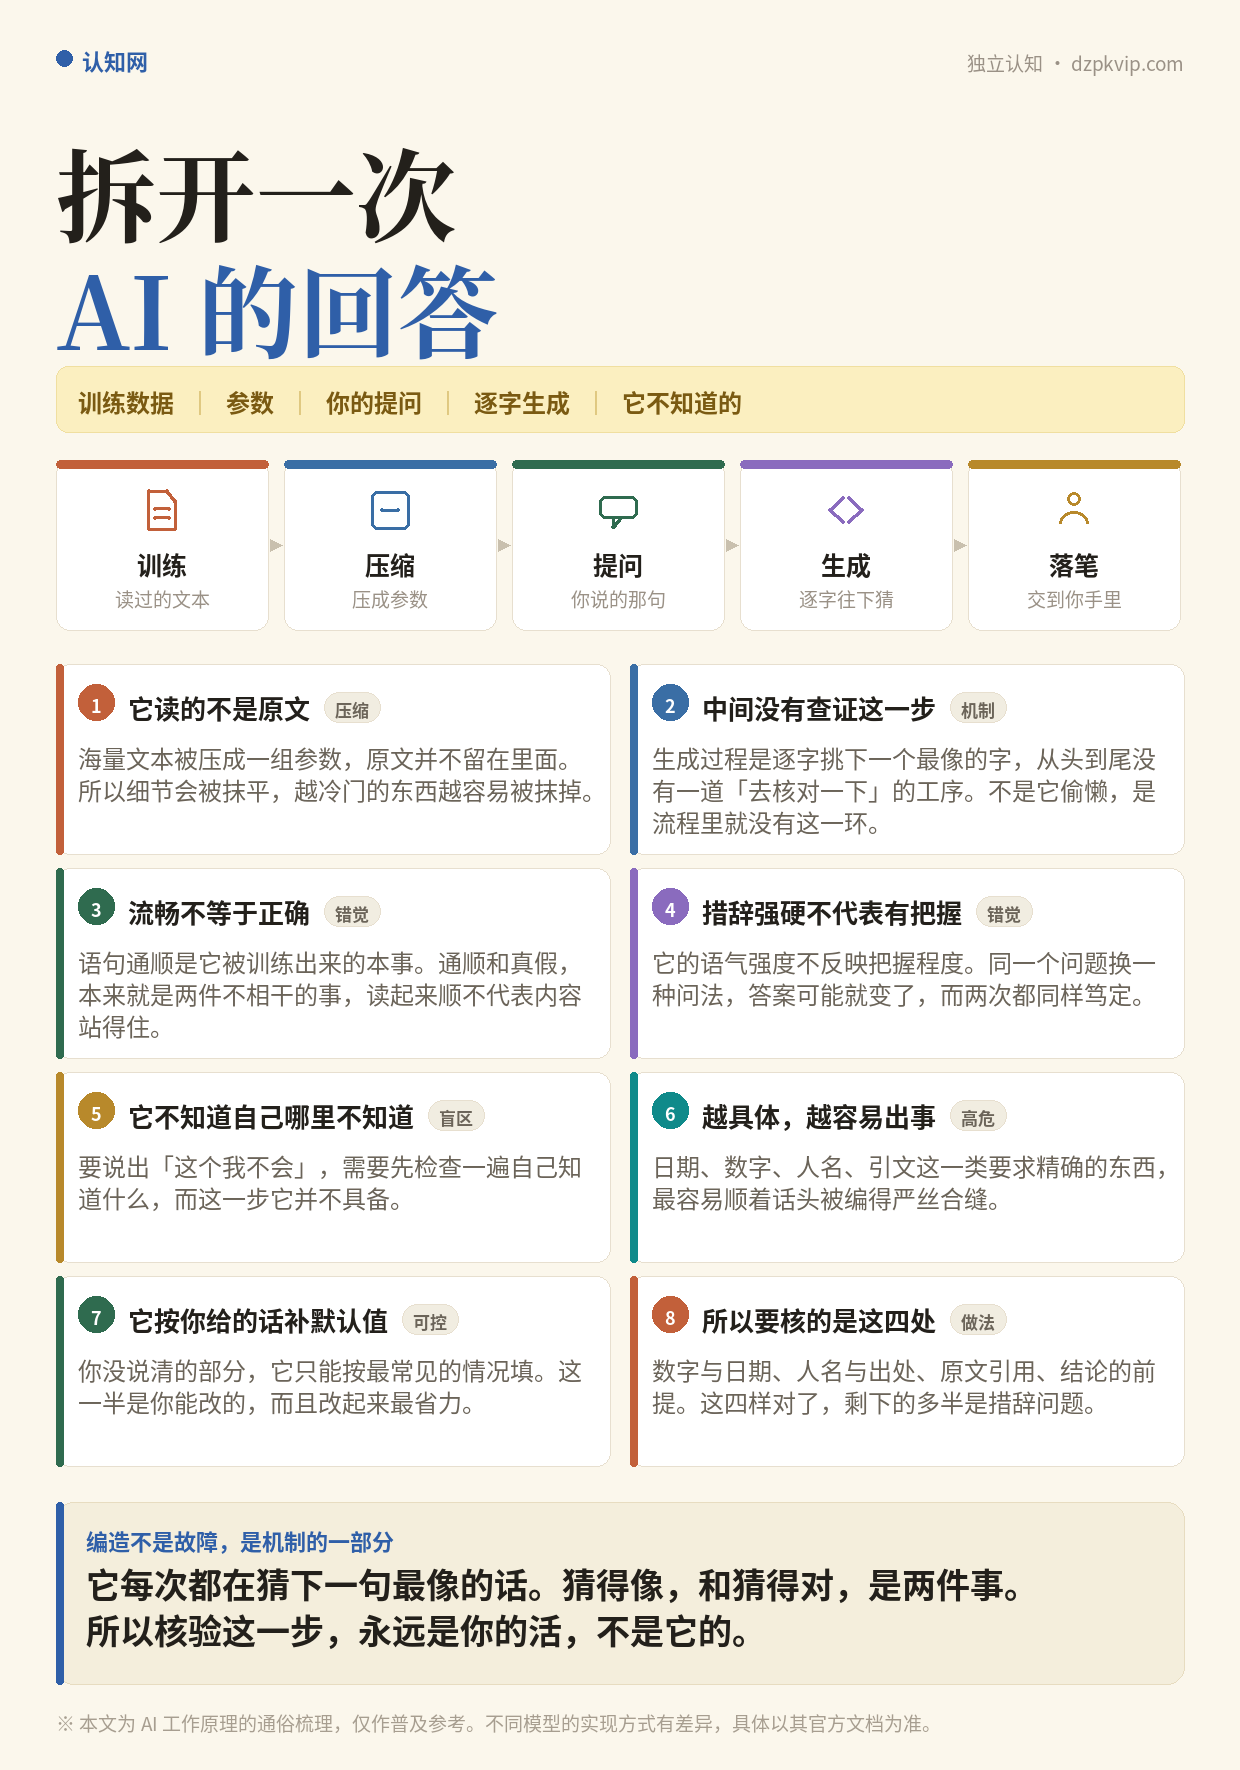
训练、压缩、提问、生成、落笔,这条链上每一环处理的都是「可能性」,没有任何一环在处理「事实」。
这不是设计缺陷,是它的工作方式。它被造出来,是为了给出最像人话的下一句,而不是最接近真相的那一句。理解这一点,后面很多奇怪的现象就都能解释了。
为什么它说得像个内行
因为它见过太多像内行的说法。医学术语、法律条文、引用格式,在训练语料里都有大量范例,模仿这些格式对它是容易的事。
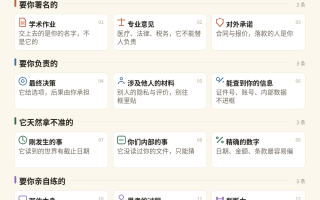
反倒是不该装懂的地方最容易露馅:一件刚发生的事、一个只有内部才有的数字、一段谁也没写过的原话。
要核的,固定成四样
数字与日期、人名与出处、原文引用、结论的前提。这四样对了,剩下的多半是措辞问题,改改就好;这四样里错了一样,整段都要重来。
这样归类的好处是:核验有了固定的起手式,不必每次都从头犹豫该查什么。
核的时候,从哪儿下手
要查一个具体数字,看 它给的数字,怎么查证;要判断一段内容是不是 AI 写的,看 怎么认出一段内容是 AI 写的。
想把整个判断过程理一遍,看 怎么审 AI 给你的建议。真要追到源头,Retraction Watch 记录论文撤稿与更正,Science Feedback 由在职科学家做核查,这两个都可以直接查。
如果只是想知道手上的东西像不像 AI 写的,也有现成的检测工具可以先用一轮:GPTZero、腾讯朱雀 AI 检测、Copyleaks。它们的结果只能当参考,不能当定论。
如果连怎么问都还没顺
先看系列前两篇:AI 工具怎么选,把工具按用途选对;怎么问,才不走样,把要求说清楚。问得清楚,要核的东西本身就少一半。
最后一句实在话:核验这一步,永远是你的活。不是因为它不可靠就要怀疑一切,而是因为这本来就是你该负责的那部分。
※ 本文为 AI 工作原理的通俗梳理,仅作普及参考。不同模型的实现方式有差异,具体以其官方文档为准。文中提到的检测工具结果仅供参考,不构成任何结论性判断。