四十页的 PDF,塞进对话框,问一句「这篇讲了什么」,三家的回答看着都像那么回事。差别在第二问:这句结论出自第几页?
读文献这件事,卡点从来不是「装不装得下」。现在主流模型的窗口都在百万 token 量级,一篇论文绰绰有余。真正分高下的是另外两格:文档能不能进得去,回答能不能核得住。
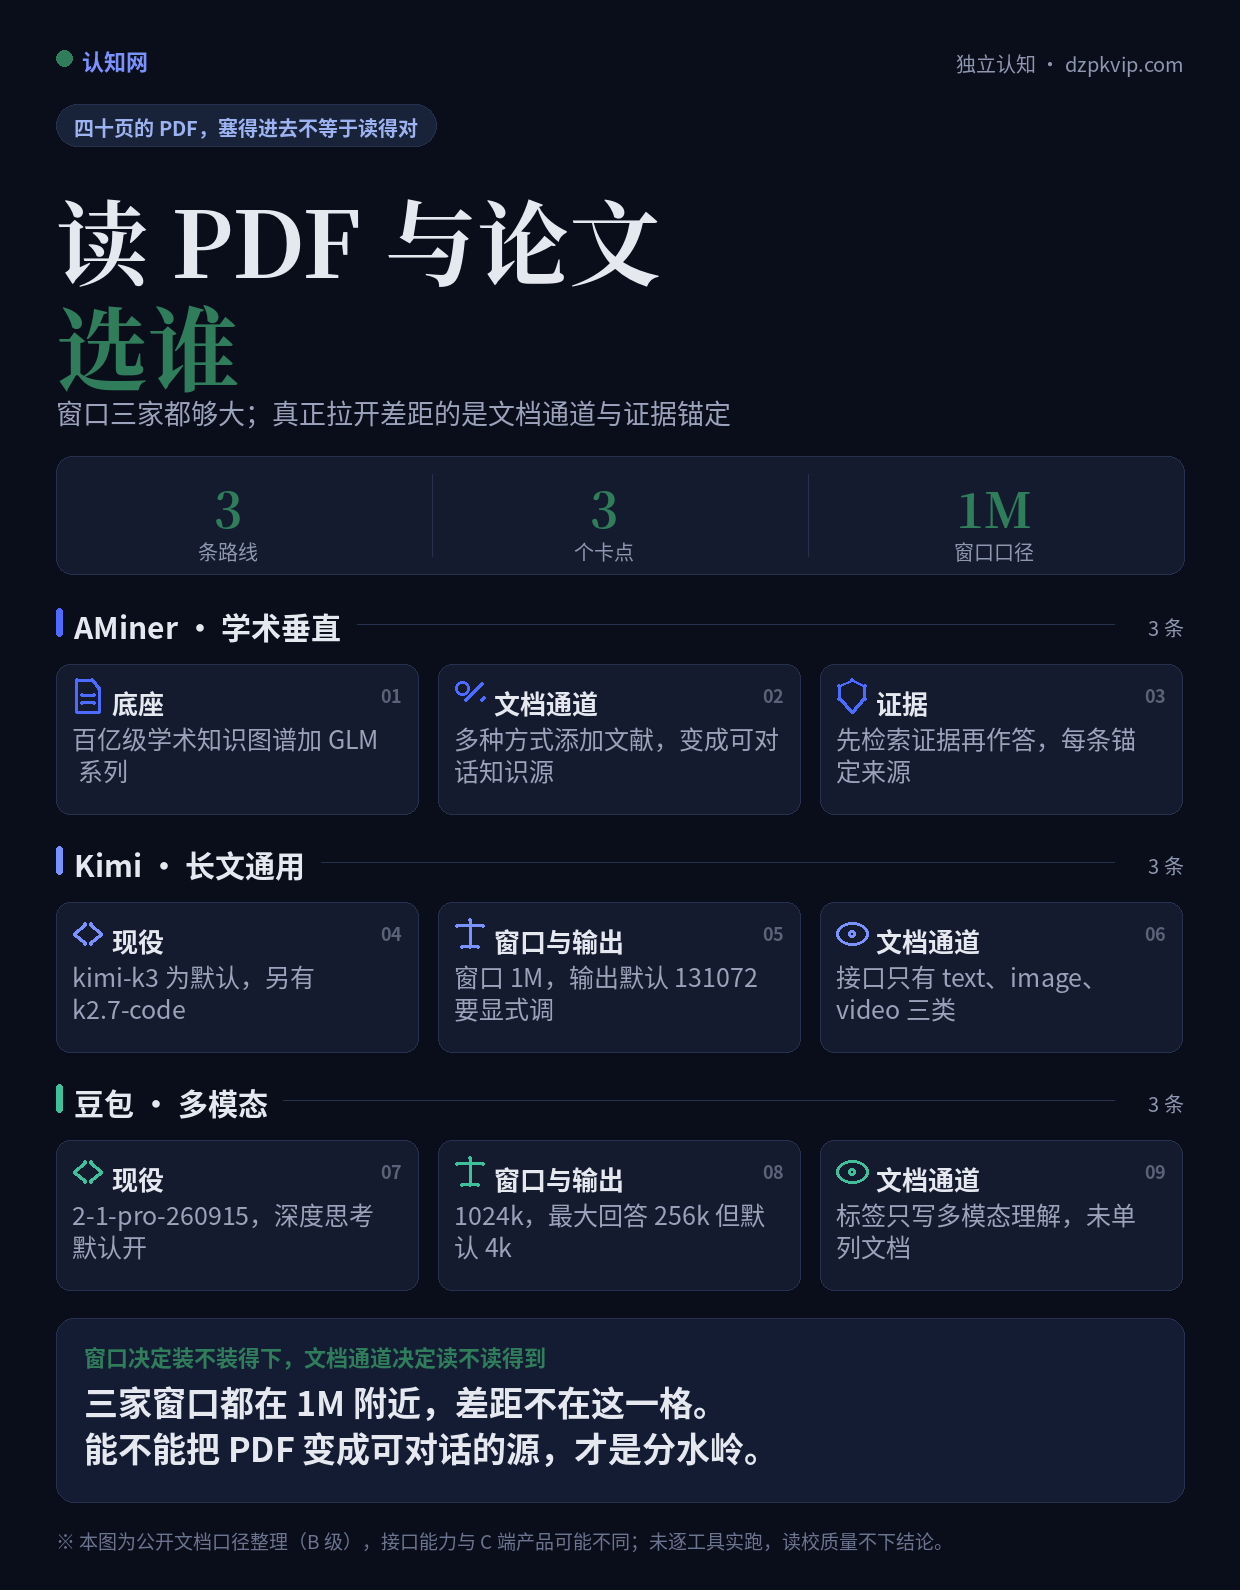
这篇按三条路线摆开:学术垂直、长文通用、多模态理解。不给名次,给条件。
三个卡点,先弄清哪个在卡你
一、装得下:窗口
窗口是单次请求能装多少 token,输入加输出一起算。这一格现在最不缺。
豆包 2-1-pro 的窗口 1024k,DeepSeek 与 GLM 的 Flash 档也是 1024k,Kimi 官网口径一百万 token。
一篇论文、一份财报、一本书,基本都在这条线以内。窗口不再是选型理由。
二、进得去:文档通道
这是最容易被忽略的一格。能塞进上下文,不等于能把 PDF 变成可检索、可定位的源。
Kimi 的接口只列三类内容:text、image_url、video_url。文件引用 ms:// 只用于图片与视频。
翻遍那一页,没有 document 类型,也没有文档解析字段。要传 PDF,得另找产品页确认。
豆包那边标签写的是「多模态理解」,文档理解只在视觉理解的教程里出现,能力标签没单列。
也就是说,接口层不承诺 PDF 解析的三家里占两家。这是实情,不是贬低。
AMiner 是唯一把这一层写进产品说明的:支持多种方式添加文献,把指定资料变成可对话的知识源。
三、核得住:证据锚定
读论文最怕的不是读错,是读得挺顺但找不到出处。这一格决定你敢不敢引用。
AMiner 的原话是:系统先检索证据再作答,每条回答锚定来源,可核对、可引用。
这句话把顺序写死了:先找证据,再答。不是先答完,再补一个看起来很真的出处。
另外两家没有这条承诺。它们的强项在别处:长文吞吐与多模态理解。
三条路线,各自的原值
AMiner:学术垂直
底座写着百亿级学术知识图谱,配 GLM 系列模型。这一格的差别不在窗口,在数据。
AI 阅读那一条点了三层:生成总结、解释概念公式图表、就这些点交互问答。三层是逐级深入的。
Research Labs 那一块补了出口:同一批文献可以转成演示文稿、播客、报告、思维导图、网页与学术海报。
沉思那一侧是流程:研究规划、文献检索、逻辑推演、报告撰写,末了接一个可修订的写作工作台。
七阶段也写全了:选题、综述、实验设计、代码实现、数据分析、论文撰写与自动审阅。
要挑毛病的话:它的页面通篇没给窗口数字。知识图谱给了,「能装多少字」这一格留白。
Kimi:长文通用
现役三个模型:kimi-k3 是默认值,另有 kimi-k2.7-code 与 kimi-k2.6。
输出那一格有坑:max_completion_tokens 默认 131072,上限 1048576。不显式调,长稿就按默认截断。
文档还专门澄清了一句:这个数是期望返回的长度,不是输入加输出的总长度。
输入加上这个数若超出窗口,请求直接报 invalid_request_error。算总量时要两份都算。
缓存两档:5 分钟与 1 小时,默认 5m,组织之间不共享,也不支持手动清除。
长对话的建议也写在文档里:历史太长就只保留最近若干条,或做消息压缩。
豆包:多模态理解
2-1-pro-260915 的规格:窗口 1024k、最大回答 256k、最大思维链 256k。
输出也有默认值坑:最大回答写着 256k,括号里注明默认 4k。不改参数,长摘要会被截。
有一个默认开着的开关:深度思考。要纯文本生成,得显式关掉。
多模态理解是它的强项:图、表、公式一起看,这类论文它的入口更顺。
条件裁定:什么活交给谁
要写综述、每个论断都要能指出出处:走 AMiner。它的证据锚定是产品承诺,不是使用技巧。
一次读进几十万字、读完还要改写或翻译:走 Kimi。先改输出上限,再谈读得怎么样。
论文里图表公式密集、要边看边推:走豆包。多模态理解加深度思考,这条最省事。
只想问一句「这篇值不值得读」:三家都行,选你手头已经登着的那个。
为什么没列秘塔
本来这张横评的名单里有秘塔。查完撤了,理由说清楚。
它的首页只有一句「没有广告,直达结果」,站内帮助页打开是空的,没有可核的文档面。
按本站纪律,拿不到官方文档的产品不写进横评。没有源就不写,这条不能开口子。
等它把文档或帮助中心做出来,再补进这张表。补之前留空,比硬凑一条强。
跑通记录与级别说明
说清楚证据级别:本篇为 B 级,公开文档交叉验证。三家都没有真实调用跑完整的读论文流程。
全部数字来自 AMiner 关于页、Kimi 接口文档与火山方舟模型列表,2026-10-20 同日读取。
等完成逐工具实跑(A 级)后,会把同一篇论文在三家的真实问答补进来,并更新级别。
什么情况下这套对照不灵
- 接口不等于产品:C 端网页版的文档上传、页数上限与接口规格是两回事,别拿接口文档否定产品能力
- 扫描版 PDF 没有文字层:得先 OCR,识别错的公式会一路错到底,三家都救不了
- 公式密集的理论文章:模型读公式弱于读文字,关键推导必须自己过一遍
- 引用必须回原库核:模型给的文献名、作者、年份都可能编,锚定来源也不等于来源正确
- 涉密与未公开稿件:别上传到在线工具,这条没有例外
相关工具档案
AMiner 的六卡与关于页两套命名,看AMiner 条目;Kimi 的现役名单与缓存两档,看Kimi 条目。
豆包的日期后缀与默认输出 4k,看豆包条目;想按「先结构后细节」的顺序读,配合读论文五步流程用。
你让模型总结一篇论文,它说「实验表明该方法显著优于基线,在三个数据集上均有提升」。你问哪三个数据集,它报了两个,第三个说不上来。
这暴露的是哪一格问题?
点一下你的选择,看答案
B。能说出观点、指不出页码,是证据链断了。要求它先定位到具体表格与段落再回答,比换模型有用。
自测:你上一次让 AI 总结论文,它给过你页码或表格编号吗?
本篇为公开文档口径整理(B 级:公开资料交叉验证),未逐工具实跑;接口能力与 C 端产品可能不同。不写金额,不评名次,不提供任何资料文件。