问「中文长文写作选哪个」,多数人先问文笔。文笔最难量化,也最不该先问。
先问四个能量化的:一次能收多少字、一次能吐多少字、默认值是多少、文档口径一致不一致。这四个都能在官方文档里查到原值,查完能筛掉一大半不合适的。
文笔这一项,只能你自己拿三篇稿子去试。本篇管的是筛掉「装不下」的那一步。
四个硬指标,先弄清楚
收得下:上下文窗口
窗口是单次请求能装多少 token,输入加输出一起算,不是只算输入。
窗口不够时,不是写得差,是请求直接报错。所以长文任务第一件事是算清楚总字数落在哪个档。
1M token 的窗口能装很多字,但中文换算是多少、各家分词怎么切,别当固定公式用,留足余量。
吐得出:输出上限
输出上限决定一次能写多长。窗口大不等于能吐得多,这两格经常被混成一件事。
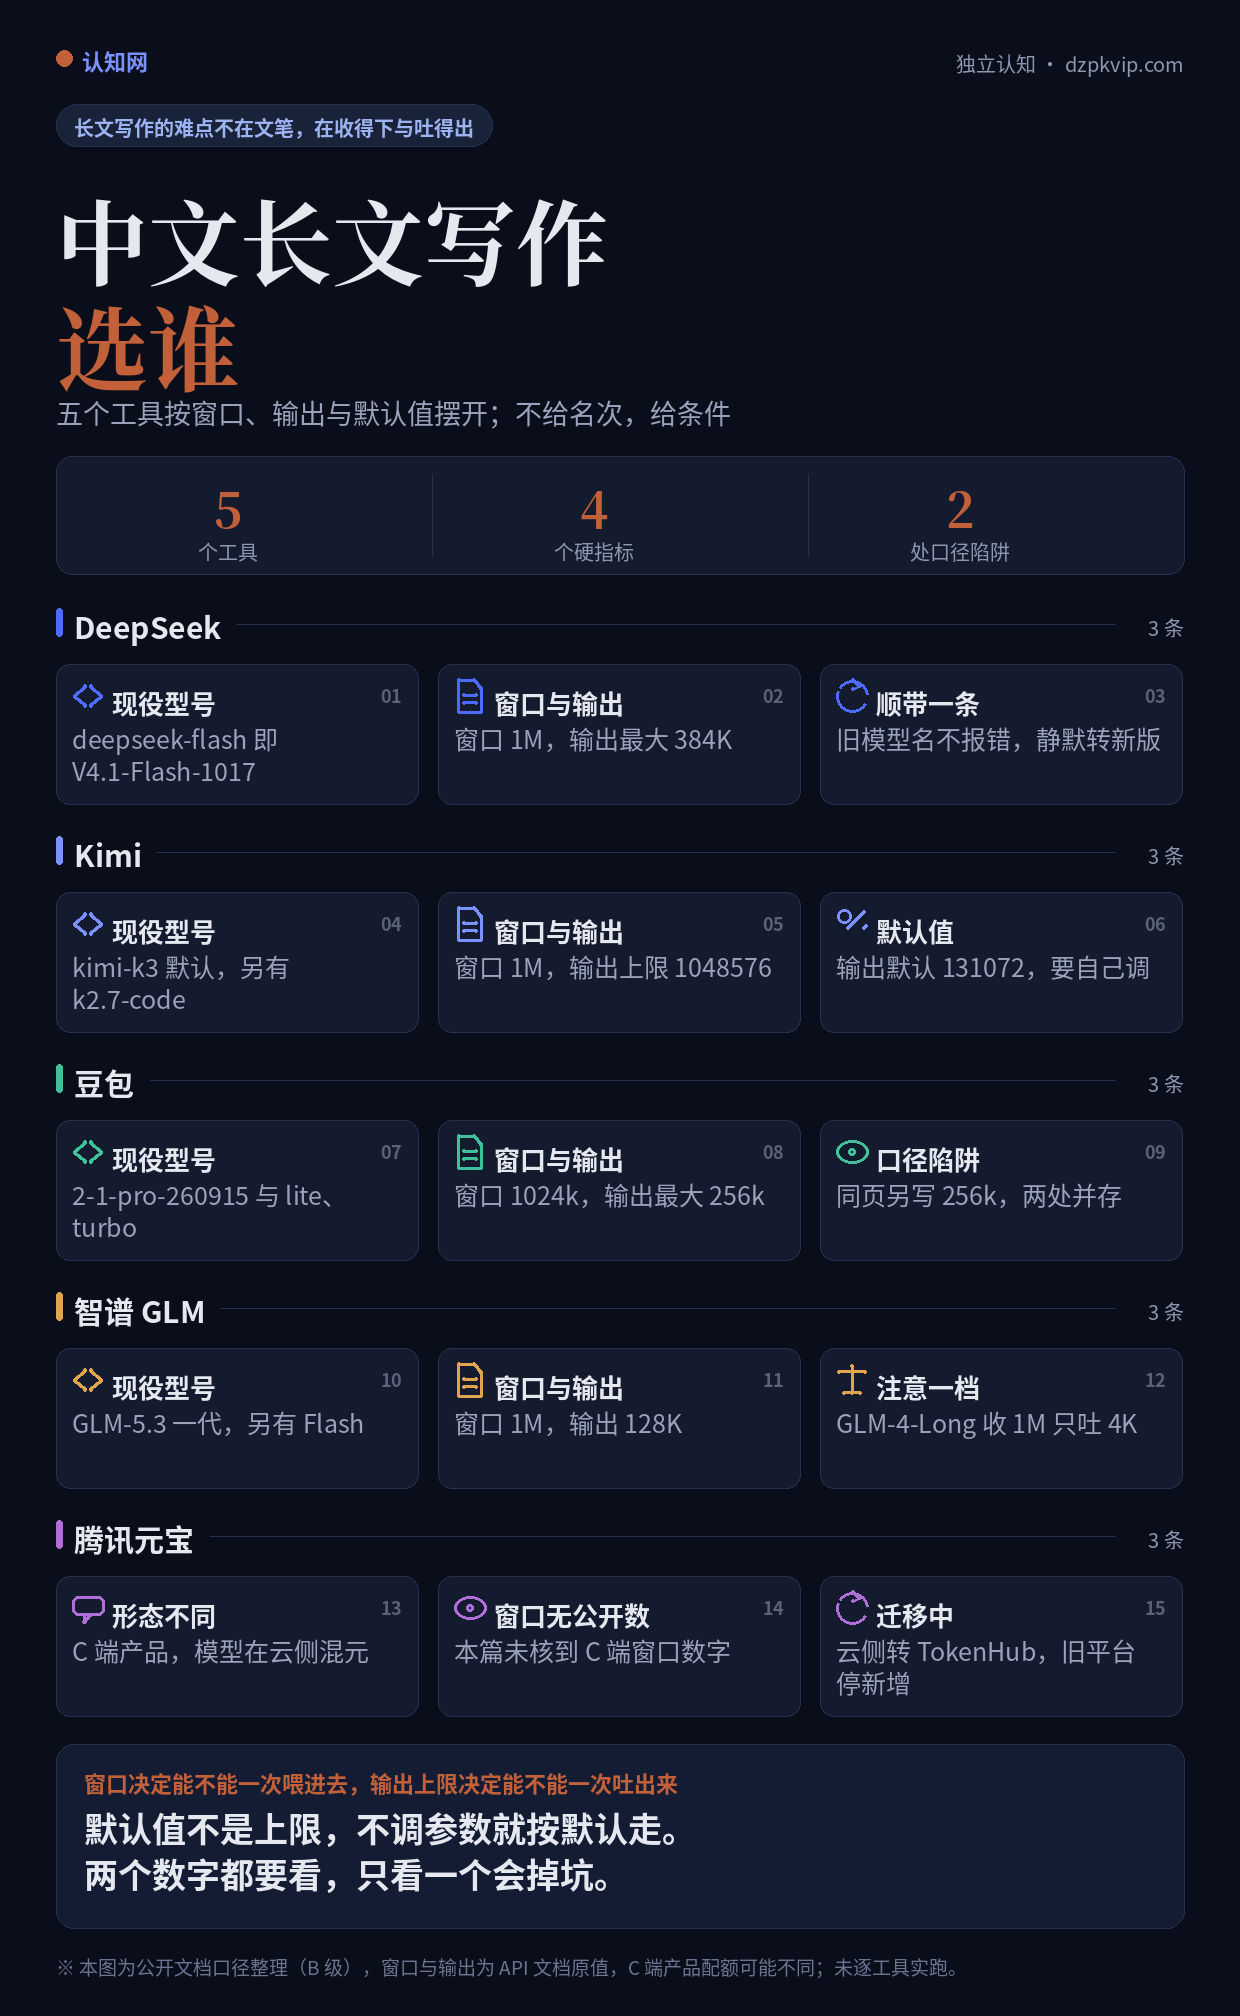
典型反例是智谱的 GLM-4-Long:窗口 1M,最大输出只有 4K。收得多吐得少,长文摘要必须分段。
默认值:最容易掉坑的一格
豆包 2-1 系列的最大回答写 256k,但文档括号里注明默认 4k。
Kimi K3 的 max_completion_tokens 默认 131072,上限 1048576。
不显式调参,长文就按默认值截断。看着像模型不行,实际是参数没给,这条坑最常见。
口径:同一页两个数
豆包 2-1 系列的窗口,在推荐模型表写 1024k,在其他模型表写 256k,同一份文档两处并存。
这类矛盾不是孤例。引用前标明用的是哪张表,上线前再对着模型详情页核一遍。
五个工具,各自的原值
DeepSeek
API 文档现役两只:deepseek-flash,模型版本 DeepSeek-V4.1-Flash-1017;另一只 deepseek-v4-pro,版本 V4-Pro-0813。
两只的上下文长度都写 1M,输出最大 384K,这是文档原值。
旧名 deepseek-v4-flash 仍可调用,但对应模型已下线,请求会被静默转到 V4.1-Flash-1017,按 Flash 计费。想锁定版本行为的人要注意这条。
Kimi
现役三个:kimi-k3 是请求默认值,另有 kimi-k2.7-code 与 kimi-k2.6。
K3 的最大生成长度默认 131072,上限 1048576;官网口径的上下文是一百万 token。
上下文缓存分 5 分钟与 1 小时两档,长文反复改稿时,前缀命中能省时间也省钱,这条对改稿流程有用。
豆包
2-1 三档:pro-260915 与 lite-260915 窗口 1024k,turbo-260628 只有 256k,差四倍。
三档最大回答都是 256k,默认 4k;深度思考默认开启,关掉要显式设参数。
lite 档限流最宽,pro 与 turbo 一致。批量任务按限流排产,别只看窗口。
智谱 GLM
模型概览页当前旗舰是 GLM-5.3 一代,含 GLM-5.3、GLM-5.3-Flash 等,窗口 1M,最大输出 128K。
往下的 GLM-5.x 档窗口 200K;GLM-4 一代里 GLM-4-AirX 只有 8K,名字像高速版,窗口反而最小。
GLM-4-Plus 已经不在模型概览页的现役名单里。照着旧教程调名,会碰壁。
腾讯元宝
元宝是 C 端产品,模型能力在云侧混元的名单里,两边是不同的入口。
C 端窗口没有公开数字,本篇未核到,不猜。云侧文档倒是明确:混元翻译模型窗口 4k,role 模型输出 4k 封顶。
云侧正在往 TokenHub 迁移,迁移后原平台不再新增模型能力。要接 API 的,先看清自己接的是哪一边。
条件裁定:什么活交给谁
一次读进几十万字再写摘要:走窗口 1M 这一档,DeepSeek、Kimi、GLM-5.3 与豆包 pro 都在这一档。
要它一口气吐几万字初稿:看输出上限。DeepSeek 384K、Kimi 上限 1048576 更宽;豆包要先把 4k 默认值改掉再谈。
逐段改稿润色:窗口与输出都不吃紧,选手头顺的那个就行,换模型的收益很小。
中文公文体、要求稳:这条文档给不了答案。自己拿三篇样稿试,看谁改得少,别人替不了。
只在网页上聊、不碰 API:元宝这类 C 端产品更省事,代价是窗口与配额不透明,长文上限只能撞出来。
跑通记录与级别说明
说清楚本文的证据级别:本篇为 B 级,公开文档交叉验证,没有真实调用跑一个完整的长文任务。
全部数字来自各家 API 文档、模型概览页与方舟模型列表,2026-10-19 同日读取,口径以原文为准。
等本站完成逐工具实跑(A 级)后,会把真实输入输出补进来,并更新级别标注。补写之前,长文质量以你自己试的为准。
三条自检清单
一查窗口:输入加输出一起算,不是只算输入。算出总量再选档。
二查输出:默认值是多少,必须显式改。默认 4k 的档位,不改就等着被截断。
三查口径:同一页出现两个数时,标明引用的是哪张表,别把两张表的数字混着用。
什么情况下这套对照不灵
- 文笔没法靠文档比:四个指标只筛掉「装不下」的,不保证写得好,也不保证风格对
- C 端与 API 是两回事:网页版的配额、上下文与模型版本都可能与文档不同,别拿文档数字当网页版承诺
- 文档会变:模型名带日期后缀,今天查到的原值,下个月可能整代换代
- 任务级没跑:长文会不会虎头蛇尾、前后自相矛盾,本篇没跑,不下结论
相关工具档案
要看清 DeepSeek 的现役名单与旧名迁移,看DeepSeek 条目;Kimi 的模型线与缓存两档,看Kimi 条目;豆包的日期后缀与档位差,看豆包条目。
GLM 的隔代与窗口差异,看智谱条目;元宝 C 端与云侧的分工,看元宝条目。
你把八万字材料塞给模型,窗口够,它也回了一大段,但只写到第三章就停了,结尾半句没写完。
最该先查什么?
点一下你的选择,看答案
B。窗口决定装不装得下,输出上限决定吐不吐得完。两个数都要查,默认值尤其容易被忽略。
自测:你上一次被长文截断,是先改了提示词,还是先查了输出上限?
本篇为公开文档口径整理(B 级:公开资料交叉验证),未逐工具实跑;窗口与输出为 API 文档原值,C 端产品配额可能不同。不写金额,不评名次,不提供任何资料文件。